ヒューマノイドと模倣学習
ヒューマノイドにおける模倣学習と強化学習の役割
現在、Unitree G1などのヒューマノイドロボットでは、模倣学習は主に上半身や腕を使った物体操作に利用されています。
例えば、人間がVRコントローラを使ってロボットの腕を操作し、そのときのカメラ画像、関節角度、手先の動き、グリッパー操作などを記録します。ACTなどの模倣学習モデルは、この操作データから「何を見たときに、腕をどのように動かすか」を学習します。
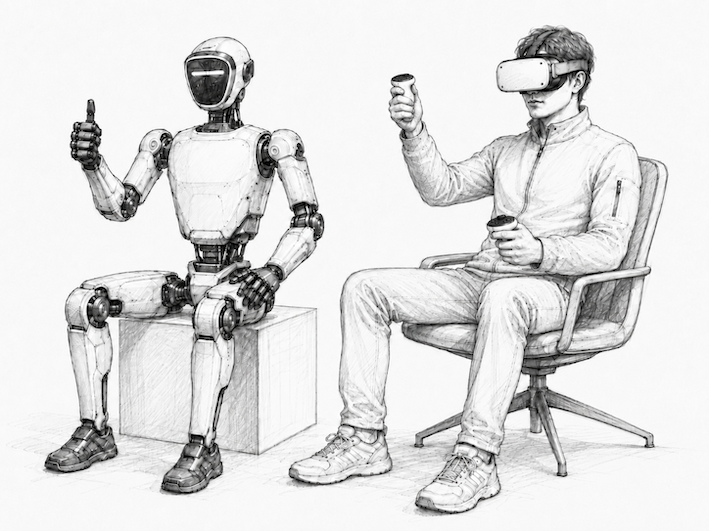
https://www.youtube.com/watch?v=pNjr2f_XHoo
これにより、物体をつかむ、持ち上げる、運ぶ、決められた場所に置くといった作業を実行できるようになります。
一方、歩行や姿勢制御のように、常に全身のバランスを保つ必要がある動作には、主に強化学習が使われます。シミュレーション内で何度も試行を繰り返し、転倒しないこと、指定された速度で進むこと、外力を受けても姿勢を戻すことなどを報酬として与えることで、安定した歩行スキルを獲得します。
近年は、強化学習に人間のモーションキャプチャーデータを組み合わせる手法も増えています。人間の歩行、ダンス、キックなどの動きを参照モーションとして与え、その動きを追跡しながら、ロボット自身が転倒しない制御方法を強化学習で獲得します。
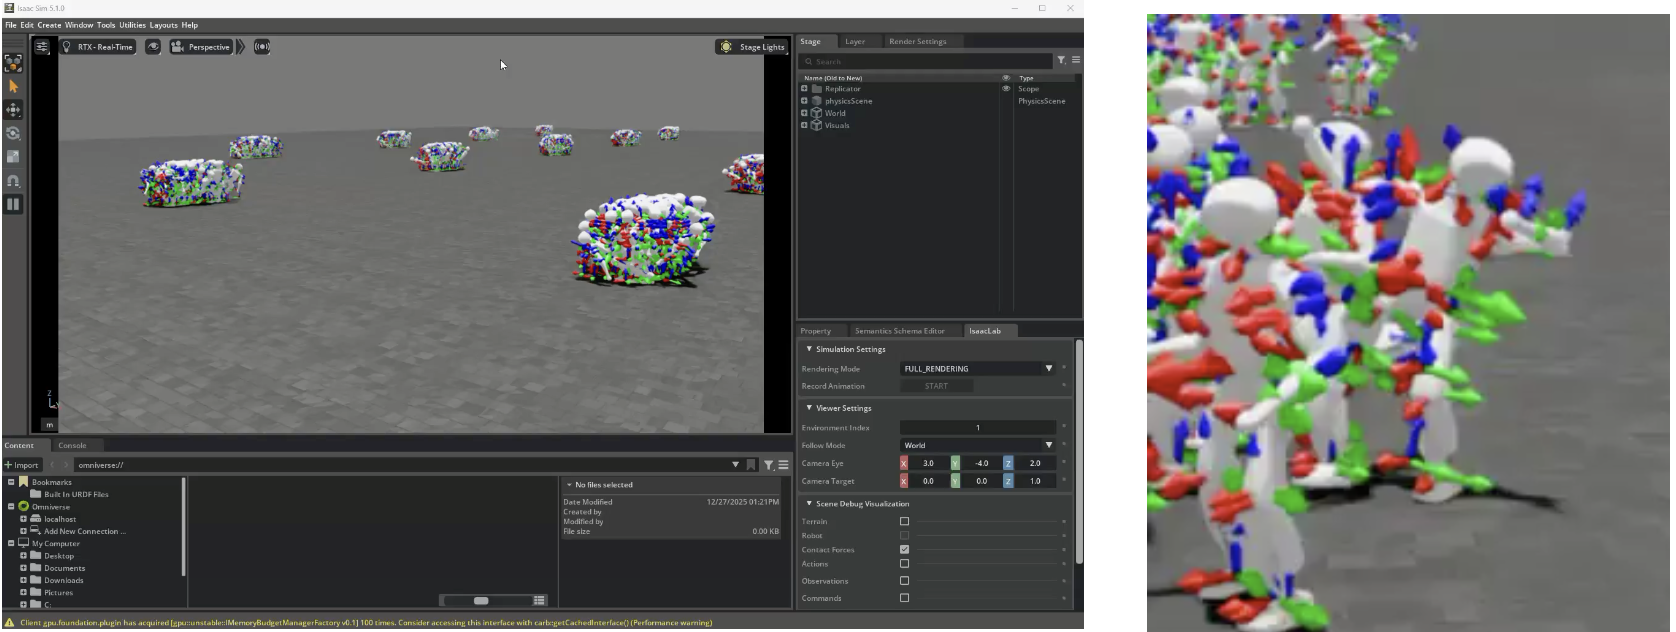
https://www.youtube.com/watch?v=29xLWhqME2Q
ただし、すべての歩行学習にモーションキャプチャーデータが必要なわけではありません。一般的なLocomotion PPOでは、前進速度や旋回速度などの指令だけを与えて歩行を学習する方法も広く使われています。モーションキャプチャーは、より人間らしい歩行や特定の全身動作を再現する場合に特に有効です。
ヒューマノイド全体の制御は、次のような役割分担で考えることができます。
| 制御階層 | 主なモデル・方式 | 役割 |
|---|---|---|
| 下半身・姿勢制御 | Locomotion PPO/WBC | 歩行、停止、旋回、バランス維持、外乱からの姿勢回復 |
| 上半身・腕の操作 | ACTなどの模倣学習 | カメラを見ながら物体を把持し、持ち上げ、運搬、配置する |
| 特定の全身動作 | Mimic PPO | モーションキャプチャーを参考に、ダンス、キック、しゃがみ動作などを再現する |
| 人間による教示 | Quest 3などのVRテレオペレーション | 人間がロボットを操作し、模倣学習用のデータを収集する |
| 全身制御 | WBC | 腕、胴体、脚の目標を調整し、全身のバランスを保つ |
| 統合・切り替え | FSM/タスク制御層/DDS | 歩行、停止、把持、運搬などの各スキルを切り替え、連続した作業として実行する |
例えば、ロボットがテーブルまで歩いて物体を持ち上げる場合、次のように複数の制御技術が連携します。
- Locomotion PPOがテーブルまで歩行する
- WBCが上半身を動かしても転倒しないように全身の姿勢を調整する
- ACTがカメラ画像を基に腕を動かし、物体をつかむ
- Locomotion PPOが物体を持った状態で移動する
- ACTが目的の場所に物体を置く
- FSMやタスク制御層が、それぞれの動作を順番に切り替える
このように、現在のヒューマノイドロボットでは、すべての動作を一つのAIモデルだけで制御するのではなく、歩行は強化学習、物体操作は模倣学習、全身の姿勢調整はWBC、動作の切り替えはFSMやタスク制御層という形で、複数の技術を組み合わせる構成が一般的です。
要約すると、次のように表現できます。
ヒューマノイドロボットでは、脚で安定して移動する能力を強化学習で獲得し、腕を使った物体操作を人間の実演データから模倣学習します。さらに、モーションキャプチャーと強化学習を組み合わせることで、人間らしい歩行やダンスなどの全身動作を学習します。これらのスキルをWBCやFSMで統合することで、移動しながら物をつかみ、運び、配置するといった複雑な作業を実現します。