模倣学習
ACT以前とACT後の模倣学習のトレンド
| 世代 | おおよその時期 | モデルへの入力 | 学習・予測するもの | 出力 | 主な特徴 | 主な弱点 |
|---|---|---|---|---|---|---|
| ACT以前の模倣学習 | 2010年代~2022年頃 | カメラ画像、関節角度 | 人間のデモにおける、現在状態から次の1動作への対応 | 次の関節位置、速度など | Behavior Cloningを中心に、CNN・MLP・RNN・LSTMで1ステップずつ制御 | 小さな予測誤差が蓄積しやすい。学習データにない状態から復帰しにくい |
| ACT | 2023年 | カメラ画像、関節角度 | 数十~100ステップ程度の一連のアクション | 関節動作のチャンク | 動作をまとめて予測することで、細かな双腕作業を滑らかに実行。少量の実演データでも学習しやすい | 基本的に特定タスク・特定ロボット向け。言葉の意味や一般知識はほぼ持たない |
| VLA | 2023年頃~ | カメラ画像、言語指示、関節状態 | 視覚・言語の意味とロボット動作の対応 | アクショントークン、関節動作チャンクなど | 「赤いコップを箱へ入れて」のような自然言語指示に対応。大規模VLMの物体認識・常識を利用 | 世界が次にどう変化するかを明示的には予測しないことが多い。精密動作には大量のロボットデータが必要 |
| WAM | 2025~2026年頃から本格化 | カメラ画像、言語、関節状態、過去の動作 | 将来の映像・世界状態と、それを実現するアクション | 未来状態+ロボット動作 | 動作した結果を「想像」しながら制御。動画事前学習から物理変化や人間動作を学べる | 動画生成・未来予測が重く、推論遅延が大きい。接触力など細かな物理の正確性はまだ課題 |
ACT
2023年、ALOHA(A Low-cost Open-source Hardware System for Bimanual Teleoperation)の登場により、それまで高価な研究用ロボットや双腕テレオペレーション設備を必要としていた高度な模倣学習の研究環境を、約2万ドル、当時の日本円で約300万円規模で構築できるようになりました。
初期のALOHAは、Follower側に2台のViperX 6-DoF、Leader側に2台のWidowXを使用するLeader–Follower型の双腕システムで、これらのアームにはROBOTIS製DYNAMIXELサーボが採用されています。市販アーム、Webカメラ、アルミフレーム、3Dプリント部品を組み合わせることで、低コストで再現可能なデータ収集環境を実現しました。
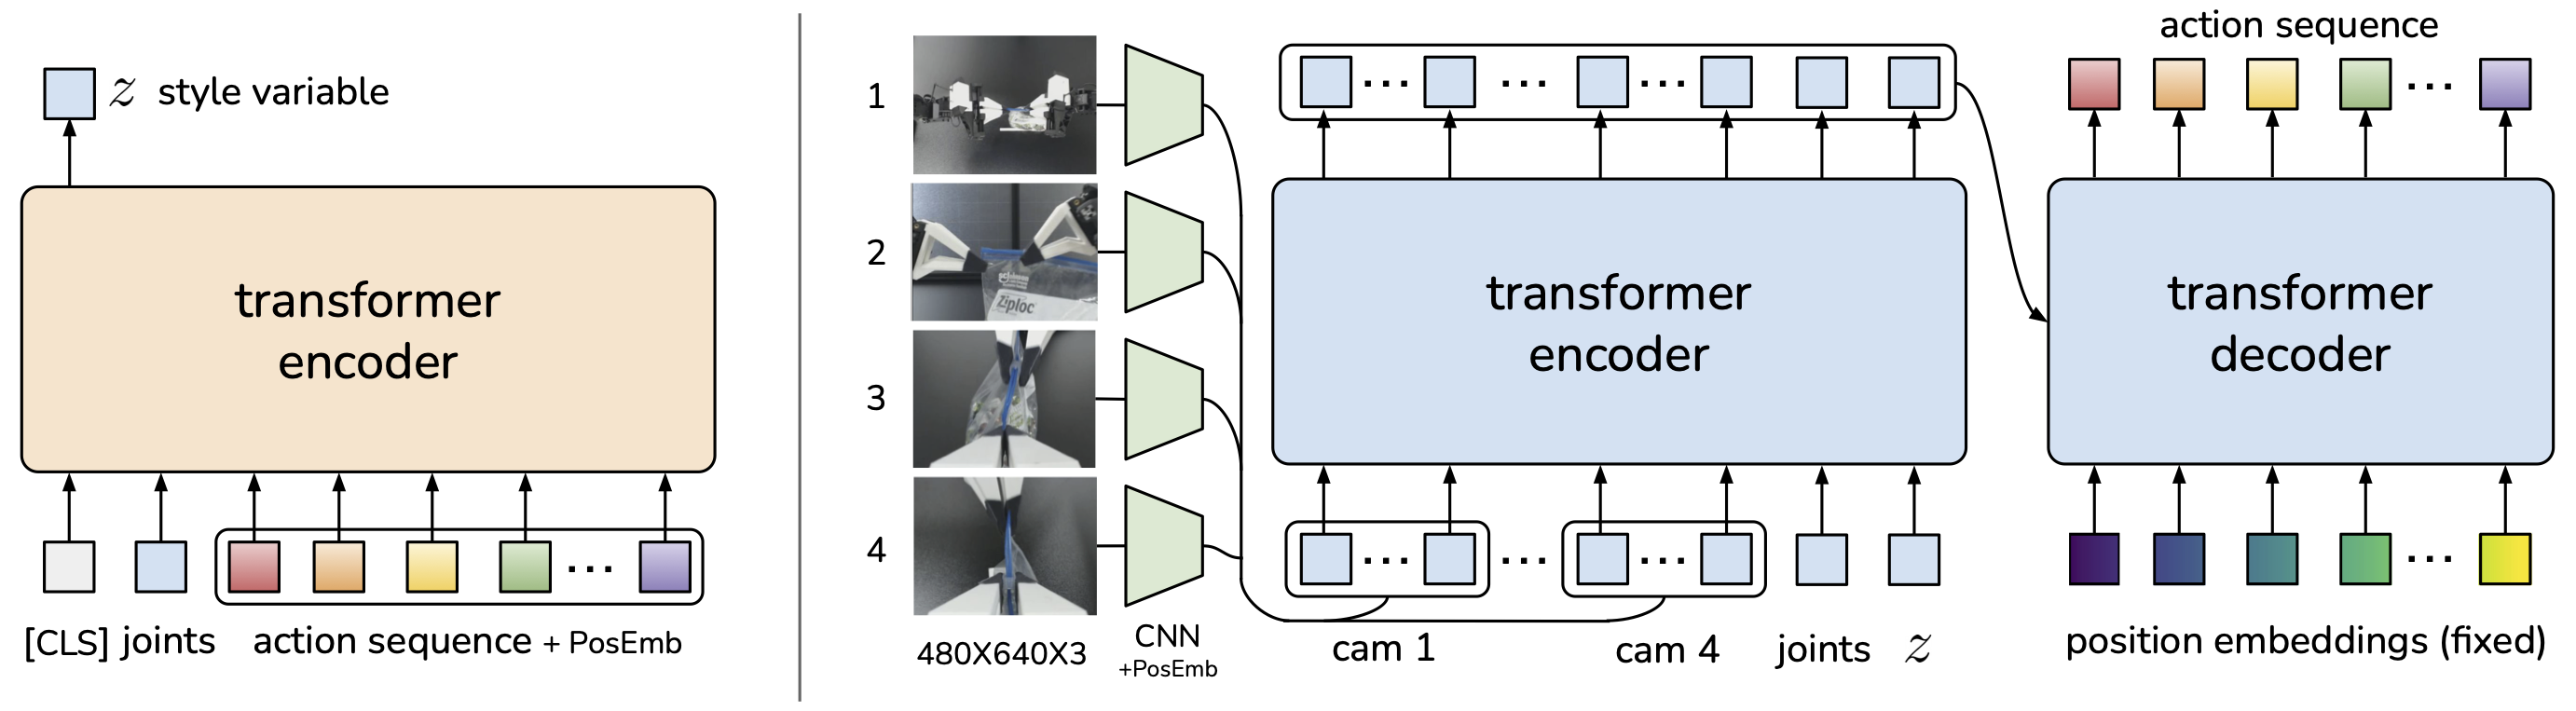
ALOHAと同時に、Transformerベースの模倣学習手法であるACT(Action Chunking with Transformers)も発表されました。ACTの公式実装は、Facebook AI Research、現在のMeta AIが発表した物体検出モデルDETRのTransformer実装を基に変更されています。ただしACTはDETRをそのまま利用したものではなく、ResNet画像エンコーダ、Transformer Encoder–Decoder、Conditional VAE、Action Chunking、Temporal Ensemblingを組み合わせた独自の構成です。
ACTの大きな特徴は、1ステップ先の動作だけを予測するのではなく、次の複数ステップ分の関節目標値を「Action Chunk」としてまとめて予測する点です。これにより模倣学習で発生しやすい誤差の累積を抑え、複雑で連続的なロボット動作を安定して生成できるようになりました。
Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware
Robotis USの説明するALOHAの特徴
Mobile ALOHA
Mobile ALOHAでは、ロボットアームの関節動作だけでなく、移動台車の走行速度も同じ模倣学習モデルの出力として学習させました。これにより、車体の移動と双腕による物体操作を一体的に制御し、移動を伴う長時間の複雑な作業を実行できるようになりました。また、従来の固定型ALOHAで収集した操作データを併用して学習することで、Mobile ALOHAのタスク成功率が大きく向上しました。